別再寫沒人看的內容:我如何靠 CBI 寫作法,把資料變成有溫度的影響力
嘿,我是麥特。 身為一個軟體工程師,我以前有個很大的毛病: 寫文章像在寫 API 文件。 我總覺得只要內容「正確」、邏輯「通順」,讀者自然就會買單。 但現實很殘酷... 我花了大把時間整理的技術心得、自動化流程,發出去後反應冷淡,點閱率低得可憐。 後來我才發現,大家在網路上不是來「上課」的。 他們是來「尋找解決方案」和「消遣」的。 如果你跟我一樣,覺得明明肚
閱讀文章 →共 94 篇,依發布日期由新到舊排列。
嘿,我是麥特。 身為一個軟體工程師,我以前有個很大的毛病: 寫文章像在寫 API 文件。 我總覺得只要內容「正確」、邏輯「通順」,讀者自然就會買單。 但現實很殘酷... 我花了大把時間整理的技術心得、自動化流程,發出去後反應冷淡,點閱率低得可憐。 後來我才發現,大家在網路上不是來「上課」的。 他們是來「尋找解決方案」和「消遣」的。 如果你跟我一樣,覺得明明肚
閱讀文章 →想提升效率卻總是拖延?本篇文章會解析 Memento Mori 的概念,並分享自行開發的「生命週曆」工具。透過視覺化生命時間 的真相,教你如何用 4,160 個星期重新定義目標,幫助普通上班族克服完美主義,奪回生活主控權,實現真正的高效生活。
閱讀文章 →你是不是也跟我以前一樣,剛學機器學習的時候,第一個接觸的就是「線性迴歸」(Linear Regression)? 那時候覺得這東西超簡單,不就是畫一條線穿過一堆點嗎?model.fit(X, y) 一行程式碼就收工了。但等我真的把這套東西拿到實戰場景,不管是預測公司的電商銷量,還是分析產品的轉化率,我才發現,現實數據根本不聽話。
閱讀文章 →你有沒有過那種感覺?洗澡的時候想到一個超棒的點子,熱血沸騰,覺得這東西做出來一定會中。結果隔天坐在電腦前,開始想:網域要叫什麼?Logo 是不是要找人設計?如果用戶很多,資料庫撐得住嗎? 然後,一個月過去了,那份專案資料夾還是只有一個 `README.md`,甚至連寫都沒寫。 這種「想太多、做太少」的症狀,我以前天天都在發生。身為工程師,我們最擅長的就是「把簡單的事情變複雜」——我們會去研究最新、最潮的技術棧,卻忘了最重要的一件事:你的
閱讀文章 →嘿,你曾經遇過這種狀況嗎? 當你拿到一份資料集,滿心期待地想跑個機器學習模型,結果打開檔案一看——欄位(Features)多到要橫向捲動好幾秒才看得完。這時候,如果你直接把這幾百個欄位全部丟進模型裡,通常會發生兩件事:第一,你的電腦風扇開始狂轉,模型跑得比烏龜還慢;第二,預測結果爛得一塌糊塗,因為裡面充斥著太多無關的「雜訊」。
閱讀文章 →前幾天我看到一篇發表在《Journal of Consumer Research》的新研究,主題超有意思: 品牌透過「取笑消費者」反而能建立更好的關係? 第一個浮現的例子,大概就是 Wendy’s、RyanAir、Postmates 這類「嘴很賤但大家又很愛」的品牌。 但問題來了—— 👉 這真的有用? 還是只是少數品牌運氣好、剛好沒翻車? 這篇研究直接用 11 個研究、實驗+真實社群數據,幫我們把這件事分析明白。
閱讀文章 →如果你有做過工具、App、或某種自動化服務,可能會遇到一個很常見的情況: 你覺得這東西很好用,但分享出去之後,卻幾乎沒有任何人詢問。 我自己在分享一些工具或自動化服務時,也遇到過一樣的狀況。 一開始我會懷疑: 是不是產品不夠好? 是不是我找錯客群? 還是其實大家根本不需要這個東西? 後來我慢慢整理出一個比較清楚的邏輯。 很多時候問題不是產品本身,而是使用者還沒走到「理解產品價值」的階段。
閱讀文章 →你可能聽過 AI、ChatGPT,也知道 AI 很厲害,但你有想過 政府其實也正在使用 AI,來改善你我的生活嗎? 為了讓政府機關在使用 AI 時更安全、負責任,也真正「用在對的地方」,數位發展部特別整理了一份《公部門人工智慧應用參考手冊》。以下就用最白話的方式,帶你快速看懂重點。
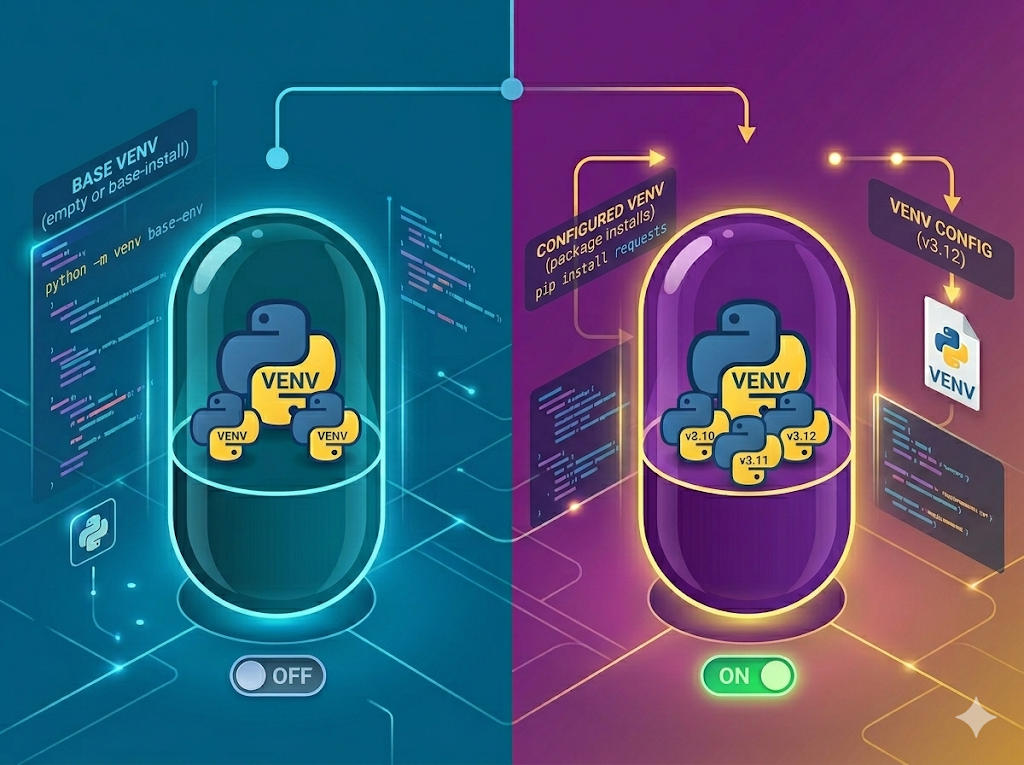
閱讀文章 →如果你在公司環境或是你在維護舊專案。 如果你不想安裝任何新工具。 那你一定要會: venv 這是 Python 內建的虛擬環境工具。 讓你可以無痛建立獨立虛擬環境,不影響現有電腦,快速進行開發。
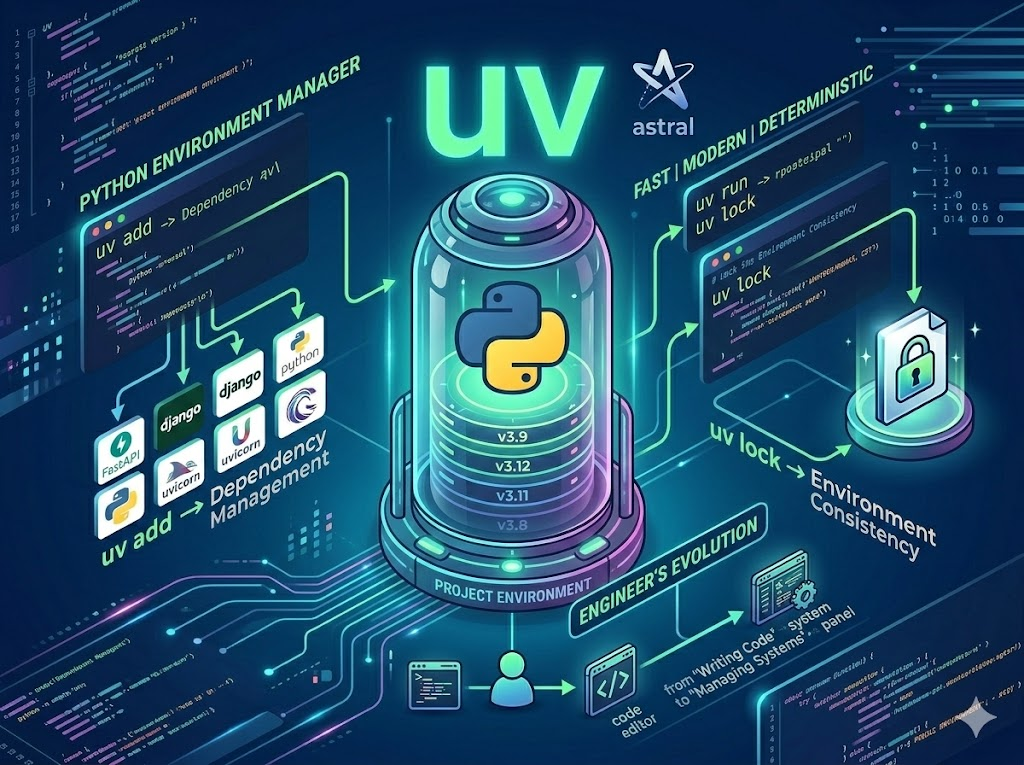
閱讀文章 →uv 是一個用 Rust 寫的 Python 套件與虛擬環境管理工具。 特色: 速度極快(比 pip 快很多) 內建 venv 功能 可取代 pip + virtualenv + pip-tools 支援鎖定依賴(類似 poetry) 如果你是新專案開發,我會優先推薦 uv。
閱讀文章 →2025 年,對我來說,是一段把「陪伴、學習、創作與科技」慢慢串起來的旅程。 這一年,我以樂齡講師的身分,走進不同的社區與教室,陪伴長輩動手做、實際操作,也在一次次的互動中,重新體會什麼叫做「學習被真正理解、真正感受到」。
閱讀文章 →當我們開始用 n8n 建立越來越多的自動化流程後,很快就會發現一件事:錯誤,一定會發生。 不論是 API 回傳 500、資料格式不一致,還是自己打錯變數名稱,錯誤處理與除錯(Debug)能力,其實是讓一條工作流能「長期穩定運作」的關鍵。 今天這篇,我就來跟你分享我自己在實作 n8n 流程時,最常用的錯誤處理與除錯技巧,幫你省下大量抓 bug 的時間。
閱讀文章 →如果你是 自架 n8n(Docker / VM / 本機), 其實 n8n 裡面提到的 Extract From File、Convert to File 那些 workaround通通都可以不用。 因為 n8n 本來就有提供一個「開關」, 可以直接決定 binary 要不要用 filesystem-v2。
閱讀文章 →最近在寫程式的時候,你有沒有一種感覺: 「不是我不會寫,是我不想再自己全部寫一遍了。」 AI 已經很明顯地改變了工程師的工作方式,但問題從來不是「要不要用 AI」,而是—— 怎麼用,才是真的在幫你省時間,而不是多一個干擾來源。 這也是為什麼我最近特別注意到 Anthropic 推出的一門免費課程: 《Claude Code in Action》
閱讀文章 →在 n8n 的世界裡, 幾乎所有「文字整理、格式轉換、資料清洗」的工作,最後都會回到一個地方:Code Node。 很多人一開始會以為 n8n 有像其他工具一樣的「Text 節點」, 但實際上 n8n 並沒有獨立的 Text Node。 文字處理 = Code Node(JavaScript) 而且放心,大多數情境只需要幾行 code, 不需要你成為工程師,也不需要寫什麼複雜演算法。
閱讀文章 →我們直覺上常認為: 只要技術進步、效率提升,資源消耗就會下降。 但經濟史與現代科技發展一次又一次告訴我們,事情往往沒那麼簡單。 這正是 19 世紀經濟學家 威廉·斯坦利·傑文斯(William Stanley Jevons) 所提出的著名觀點—傑文斯悖論(Jevons Paradox)。
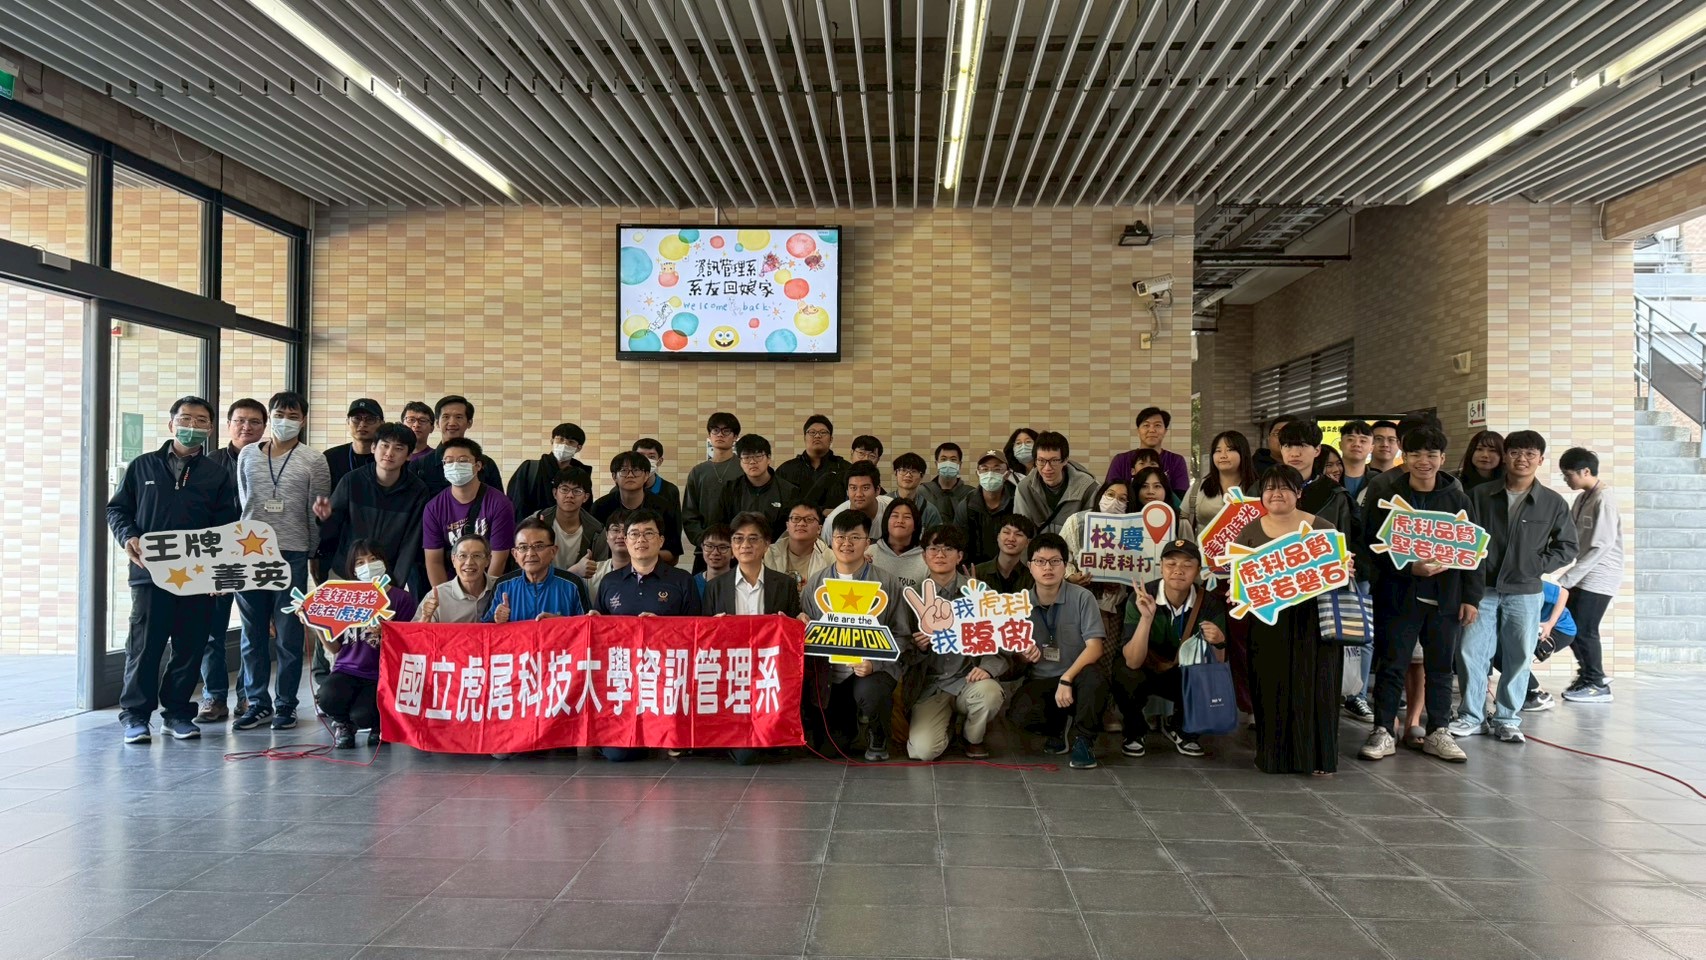
閱讀文章 →很榮幸受系主任邀請,回到熟悉的大專研究所,與學弟妹們分享自己的求學與就業心得。 短短 20 分鐘的時間,我將內容分成三個章節,希望能從自身經驗出發,給正在探索未來方向的學弟妹一些實際的參考。
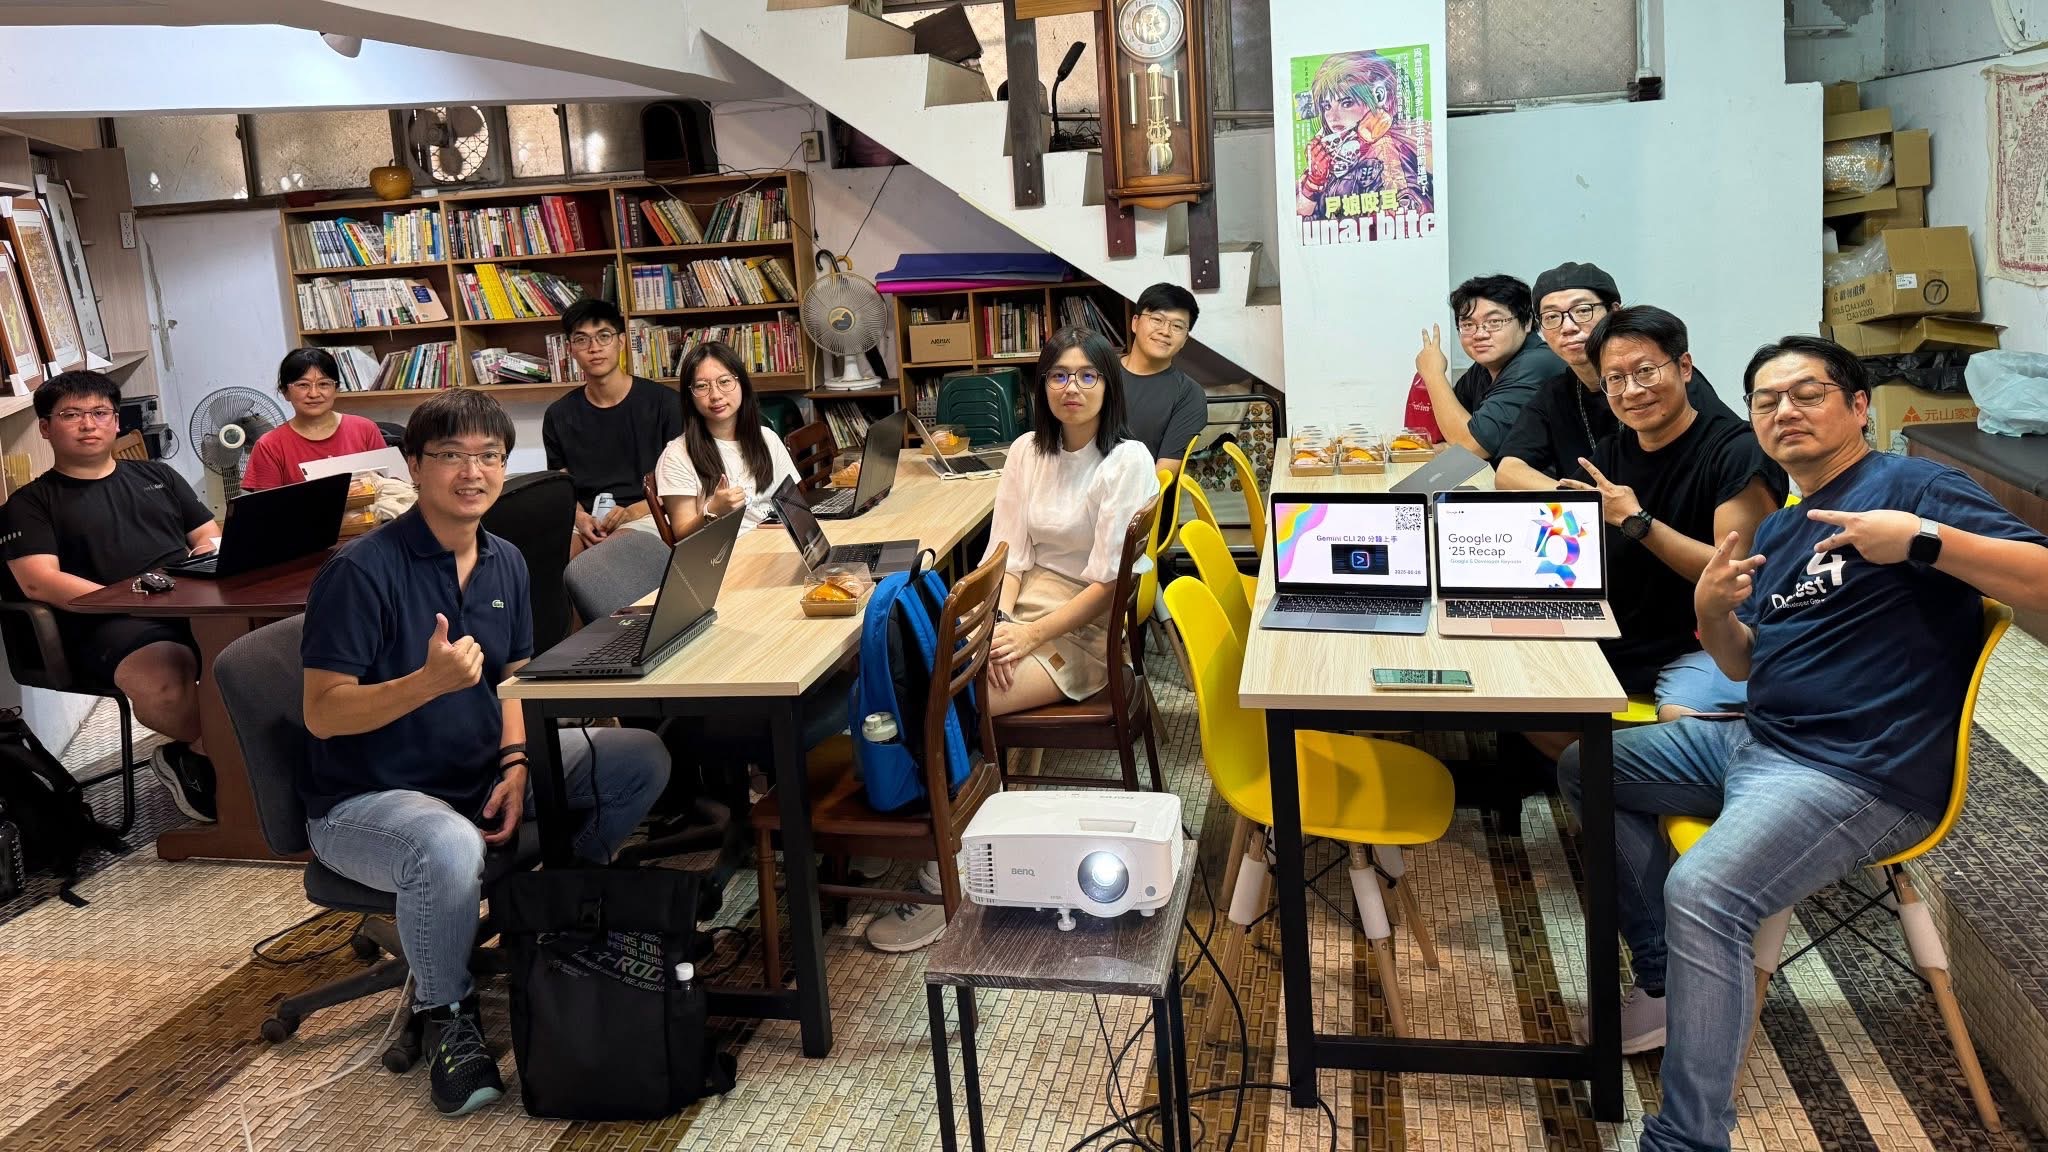
閱讀文章 →這次參加了 彰化 Google 工作坊小聚,對我來說是一個滿特別的經驗。 因為這其實是我第一次參加以科技為主題的工作坊型社群活動。 在報名之前,心情是既期待又怕受傷害,一方面很想知道大家都在關注哪些新技術,另一方面也擔心自己的認知程度,會不會和現場的講者、與會者有很大的落差。 但實際參加之後,我發現自己多慮了。
閱讀文章 →假設你是一位資料分析師,負責監測工業設備的健康狀態。 設備每天都在固定的周期模式下運轉,你希望找出潛在的異常,並預測設備的退化情況。 在這個情境下,固定周期特徵測試 (Fixed Cycle Features Test, FCFT) 提供了一種精簡但功能強大的方法,幫助你提取穩定狀態的訊號並進行深入分析。
閱讀文章 →如意原本的志願是成為電影導演,卻因為經費不足、拍攝被迫中斷,暫時停在半途。但命運很有意思,留下來的火鍋店片場,卻意外吸引了客人上門消費;而他的岳父又剛好是四川火鍋廚師,也曾教過他煮火鍋,進而挖掘出如意在料理上的天賦。
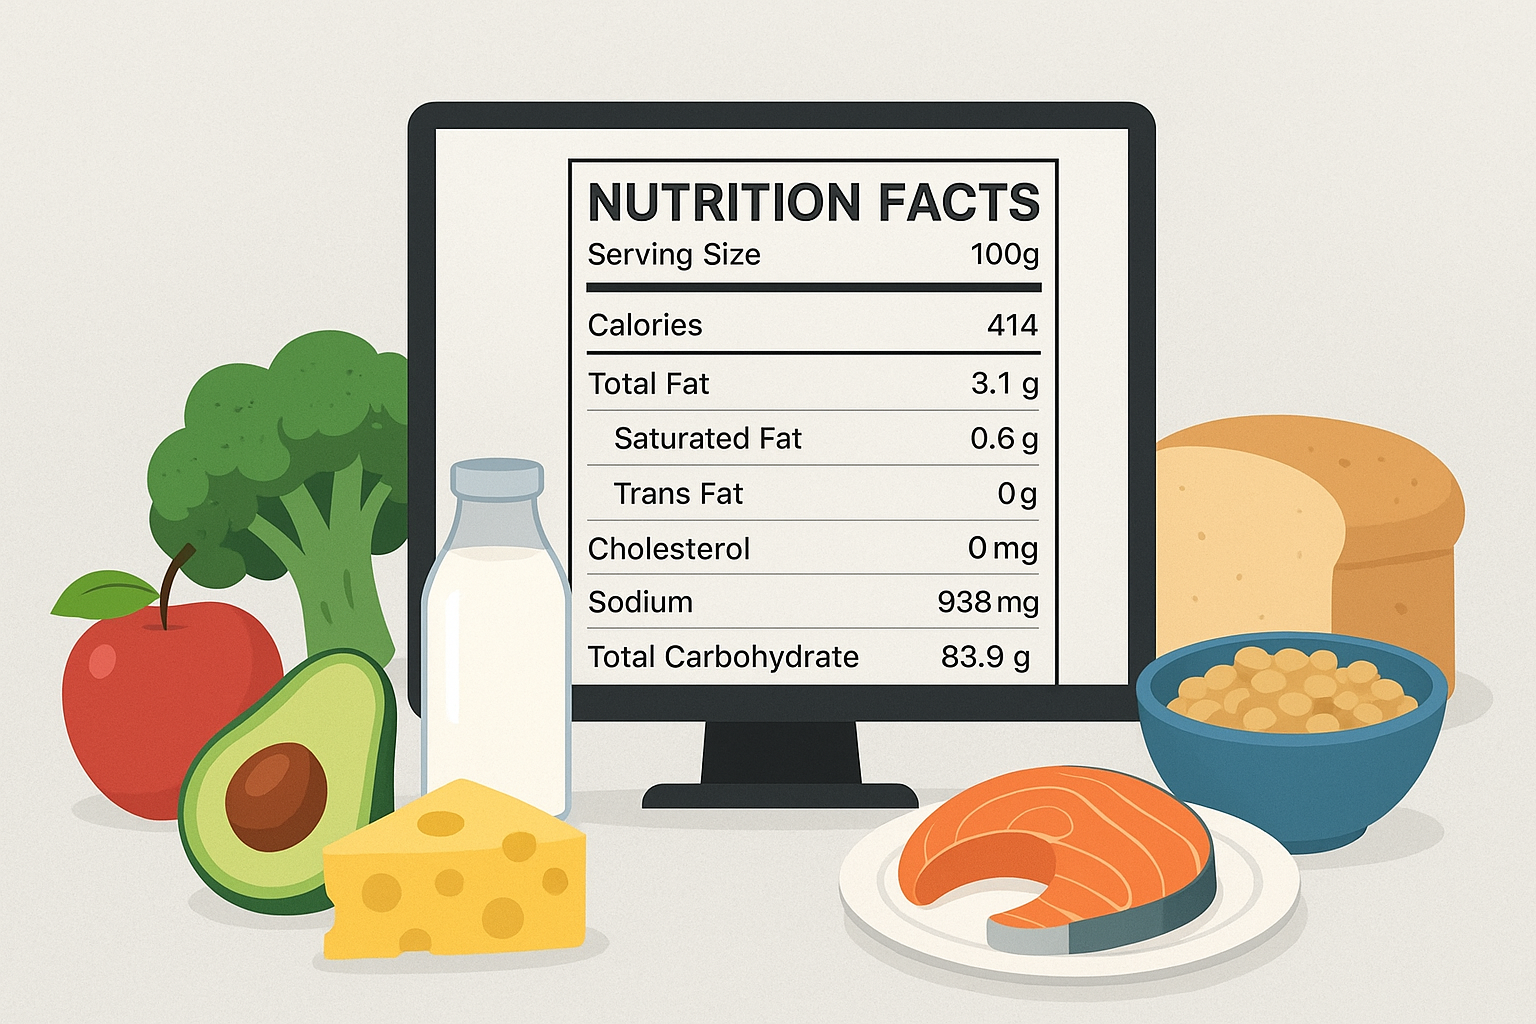
閱讀文章 →如果你做過食品產品,你一定懂這句話的重量: 「配方都定了,怎麼還不能上市?」 答案通常只有一個「營養標示」還沒搞定。 不是算不出來,而是流程太慢、風險太高。 你要確認每一個原料數據、反覆人工計算比例、等供應商補資料,甚至還得排隊等化學檢驗報告。 在這段時間裡,研發卡住、行銷空轉,上市時程只能一延再延。 真正燒掉的不是錢,是時間與機會成本。
閱讀文章 →如果你做過食品相關產品,你一定懂我接下來要說什麼。 營養標示,真的很煩。 不是「有點麻煩」那種煩,是那種: Excel 開了十幾個分頁、原料營養標示一張一張對、配方比例算到懷疑人生,最後還要擔心「我這樣算有沒有踩法規」 我自己兩年前就在這個地獄裡待了好幾個禮拜。 那時候為了一個新產品,我反覆核對化學檢驗報告、食品法規、原料標示數值,光是「確定沒有算錯」就花掉大量時間。 真正痛的不是計算,是不確定感。
閱讀文章 →如果你在食品業待過一段時間,一定懂這種感覺。 研發終於把配方定案了, 行銷也準備好要對外宣傳了, 通路商的檔期已經排進行事曆。 但你心裡很清楚真正的關卡,現在才要開始:營養標示。 不是算不出來, 而是「不能算錯」。 一個數字多一點、少一點, 不是改個檔案那麼簡單, 而是可能牽動罰款、下架、甚至品牌信任。
閱讀文章 →如果你有做影片、Podcast、短影音、教學內容,或是像我一樣偶爾會遇到「配音卡關」的情況,那你最近一定會聽到一個名字——ElevenLabs。 它基本上就是把「AI 配音」這件事做到極致,做到你會懷疑: 欸…這真的是機器嗎? 這篇就讓我帶你快速看懂它到底強在哪裡、能怎麼用、誰適合用。
閱讀文章 →在 Windows Server 環境上使用 Docker 建置 Nginx Proxy Manager(NPM),是一個能快速建立反向代理、管理多個服務、套用 SSL 憑證的做法。 本文依照實際專案經驗,將整個流程重新整理成有邏輯、可複製的紀錄,並完整收錄過程中遇到的錯誤、診斷方式與解決方法。
閱讀文章 →最近,我做了一件很書呆子但意外讓我收穫滿滿的事—— 我花了一整個週末,把自己拆解成一份「個人使用說明書」。 靈感來自老魚的文章,他把自己的人生用「產品說明」的方式重新整理。
閱讀文章 →老實說,我剛開始用 n8n 的時候,最頭痛的一件事就是 「如果我收到一整包資料,要怎麼一筆一筆處理?」 例如:一次收到 50 筆訂單,要依序寄信處理、從 API 回來一串資料,要針對每個項目進行分類或是自己做的爬蟲抓了一堆結果,想一條一條存進 Google Sheet 這時候如果你還在用 Function 寫 for 迴圈,那太辛苦了,這件事能放心交辦給 n8n。 因為 n8n 早就幫我們準備好超好用的工具:Loop 節點。 這顆節點可
閱讀文章 →上一篇我們聊到 n8n 的資料流轉,其實那就是一條資料的高速公路。 但你會發現,現實中的自動化流程可不只是「從 A 跑到 B」這麼單純。
閱讀文章 →在玩 n8n 這段時間,我越來越覺得一個自動化流程的「靈魂」其實不在多有趣的介面,而是在資料怎麼在節點之間流轉。 也就是說,當我們在畫這些線、連這些節點的時候,其實我們就是在定義「資料的命運」。 今天這篇,就來跟你聊聊我最一開始接觸 n8n 的時候卡最久的一件事:節點(Node)到底是怎麼傳資料的? 能夠自然的開始理解這件事,你對 n8n 的掌握度會瞬間升級。
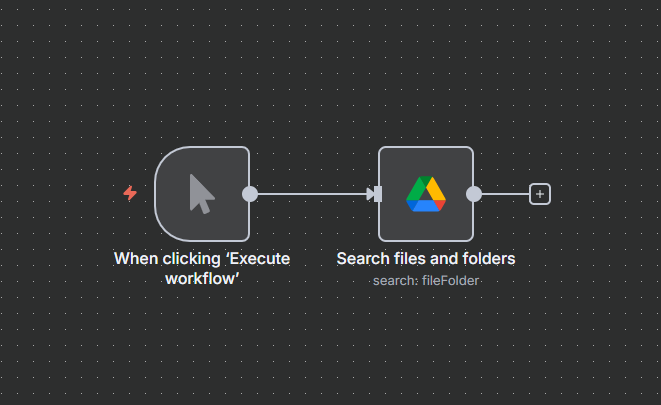
閱讀文章 →還記得你第一次寫程式時的那種「哇!居然跑起來了!」的感覺嗎? 對我來說,第一次做出自己的 n8n 自動化流程,就是那種小小成就感再現的時刻。 這篇文章我會帶你從零開始,實際體驗 n8n 的第一個自動化工作流。不用會寫程式,只要有一點點好奇心,你就能讓電腦替你自動化一件重複的小事。
閱讀文章 →對很多剛開始創業的人來說,總覺得創業一定要:找合夥人、租辦公室、擴大規模。 但《一人社長高獲利經營法則》的作者:一圓克彥,提出了完全不同的觀點。
閱讀文章 →在企業級的服務架構中,「反向代理」是不可或缺的一環。 本篇文章將示範如何透過 Docker 容器 部署應用服務,並搭配 Nginx、DNS 域名解析 以及 SSL 憑證,打造一個 安全、可靠、具延展性 的反向代理環境。
閱讀文章 →很多人在架設自己的服務時,常常會聽到一句話: 「你要先把 DNS 指過來、再用 Nginx 反代、然後申請 SSL 憑證。」 但這三者到底是什麼?它們又是怎麼串在一起的? 今天就用一篇淺顯易懂的文章,帶你快速釐清 DNS、Nginx、SSL 憑證 這三大反向代理的關鍵角色。
閱讀文章 →在數位化的時代,時間就是金錢,效率就是競爭力。無論是個人還是企業,能否快速且有效率地完成重複性任務,往往成為勝負的關鍵。而 n8n 正是這樣一個工具,它讓你以最低的成本,實現自動化的超能力!如果你還不認識 n8n,這篇文章將帶你快速了解它的核心概念、與其他自動化工具的比較,以及它的優勢所在。
閱讀文章 →為什麼食品廠需要 AI 自動化營養標示工具?在食品產業裡,營養標示是新產品能否順利上市的關鍵。 傳統方式通常需要研發人員手動計算,還得送到外部實驗室檢測,流程既冗長又昂貴。 為了幫助食品廠與烘焙業者解決這個痛點,我開發了 AI 自動化營養標示工具。
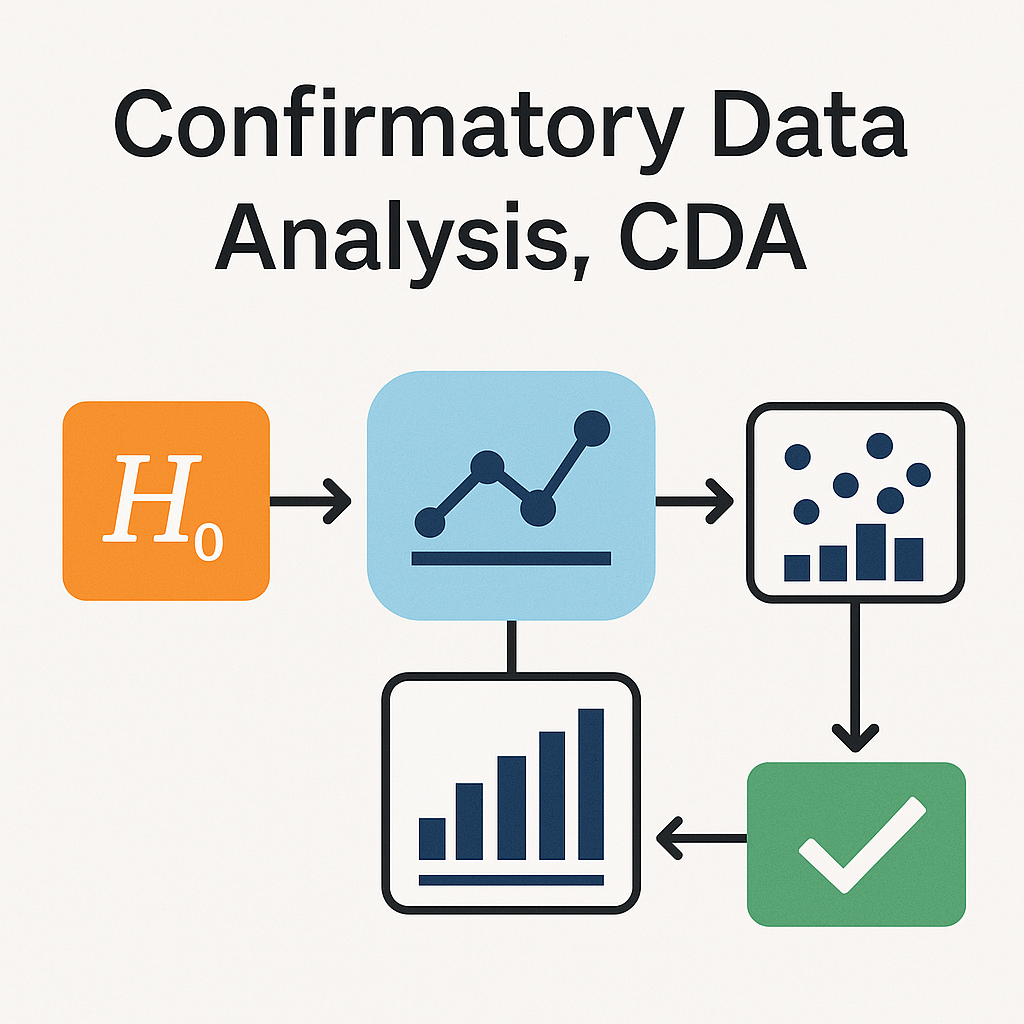
閱讀文章 →驗證性資料分析(Confirmatory Data Analysis, CDA)是一種以假設為導向的資料分析方法,主要用於驗證或拒絕事前提出的假設。
閱讀文章 →你是不是也遇過這樣的情況:花了很多時間跟 ChatGPT 對話,卻常常得到 模糊、無用或跟需求不符的答案? 別擔心,這不是 AI 的問題,而是「提示詞(Prompt)」沒有設計好。 就像是跟人溝通,如果說的內容不清楚,對方自然很難做到最好。
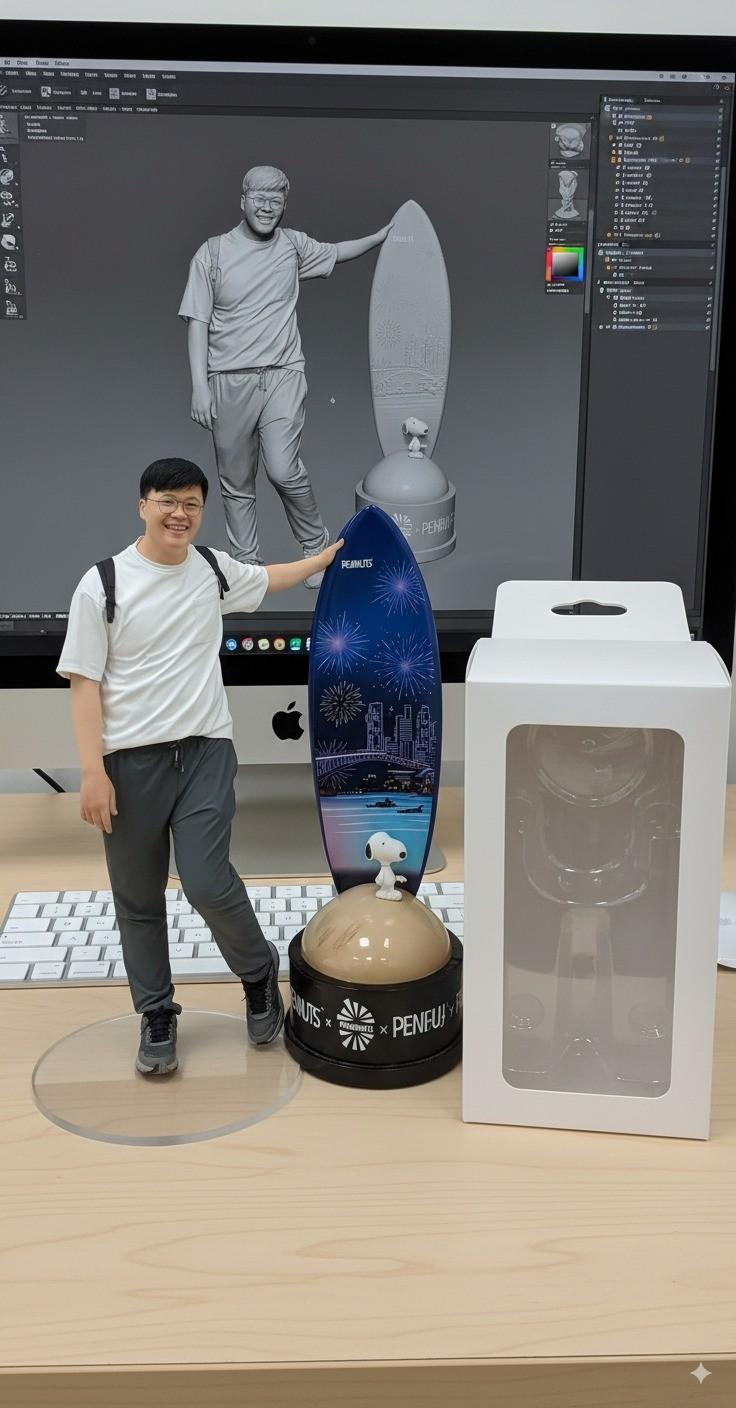
閱讀文章 →嘿~大家好,我是麥特 👋 最近 Google 推出了一個全新的影像生成模型 —— Nano Banana。如果你也曾經想要把腦海中的角色變成實體般的微縮公仔,這個工具真的可以滿足你的願望。今天就帶你一起來認識它,還會教你怎麼在 Google AI Studio 平台上實際操作,用提示詞生成超寫實的 1/7 比例公仔照片!
閱讀文章 →在資料分析的世界裡,我們經常聽到「探索性資料分析(EDA)」這個詞,但其實在真正進入嚴謹的統計推論之前,有一個更具系統性的步驟,那就是「驗證性資料分析」(Confirmatory Data Analysis, CDA)。這篇文章將帶你從概念出發,理解 CDA 的定位與用途,並說明它在資料科學與研究中的重要性。
閱讀文章 →還在手算營養成分?介紹營養標示自動化工具 NutriTag(nutrition label automation),專為烘焙工作室與食品研發設計。只需輸入配方,5 分鐘自動生成合規標籤。這款高效的應用工具能串接衛福部資料庫,讓食品標示更精準、更簡單。
閱讀文章 →最近幾年生成式 AI 工具從新奇玩具開始成為了實用工具,越來越多企業開始尋求導入 AI 來協助處理內部流程、簡化重複工作,企業漸漸轉型為藉由資料驅動的商業行為。
閱讀文章 →n8n 是一款類似 Zapier、Make.com 的開源自動化工具,可以幫你把重複性的工作流程自動化,而且 免費、可自架、不限流程數量。 本篇文章會教你怎麼透過 Docker 在本機快速部署 n8n,沒有程式基礎的你也能開啟你的自動化人生!
閱讀文章 →最近我開始準備一張新的證照考試 - AI應用規劃師(AIAP),這張證照是由經濟部產業發展署與工業技術研究院共同推動的,主打的是人工智慧的實務應用與規劃能力。 對我這種每天都在做AI應用開發的人來說,這不只是個學習檢驗,也是一種自我挑戰!
閱讀文章 →我們都知道肝臟是人體的「解毒工廠」,但你知道它其實也具備很強的「自我修復能力」嗎? 最近我在 PubMed 上看到一篇 2025 年發表在 Nature 的研究,內容實在太讓人驚艷,想跟你們分享一下。
閱讀文章 →LM Studio + AnythingLLM 是目前最完美的「本地 AI 解決方案」LM Studio 提供模型運行環境(API Server),而 AnythingLLM 則能讓 AI 讀取你的 PDF 與筆記,建立私人的 RAG(檢索增強生成)系統,本篇教學將帶領 AI 小白從安裝到連動,10 分鐘完成個人 AI 伺服器部署。
閱讀文章 →想學 Docker 卻不知道從何開始?本篇為程式初學者提供 2026 最完整的 Docker 安裝指南。涵蓋 Mac install Docker、Windows install Docker (WSL 2) 及 Linux install Docker 的詳細步驟,助你快速搭建開發環境並成功運行第一個容器。
閱讀文章 →你可能常常在網路上看到 Docker 被一堆工程師大推,甚至還有人說「不會 Docker 就落伍了!」但到底什麼是 Docker? 它又解決了什麼問題? 這篇文章,我會使用最簡單的方式,把這項看起來很複雜的技術用幾單的舉例讓你秒懂。
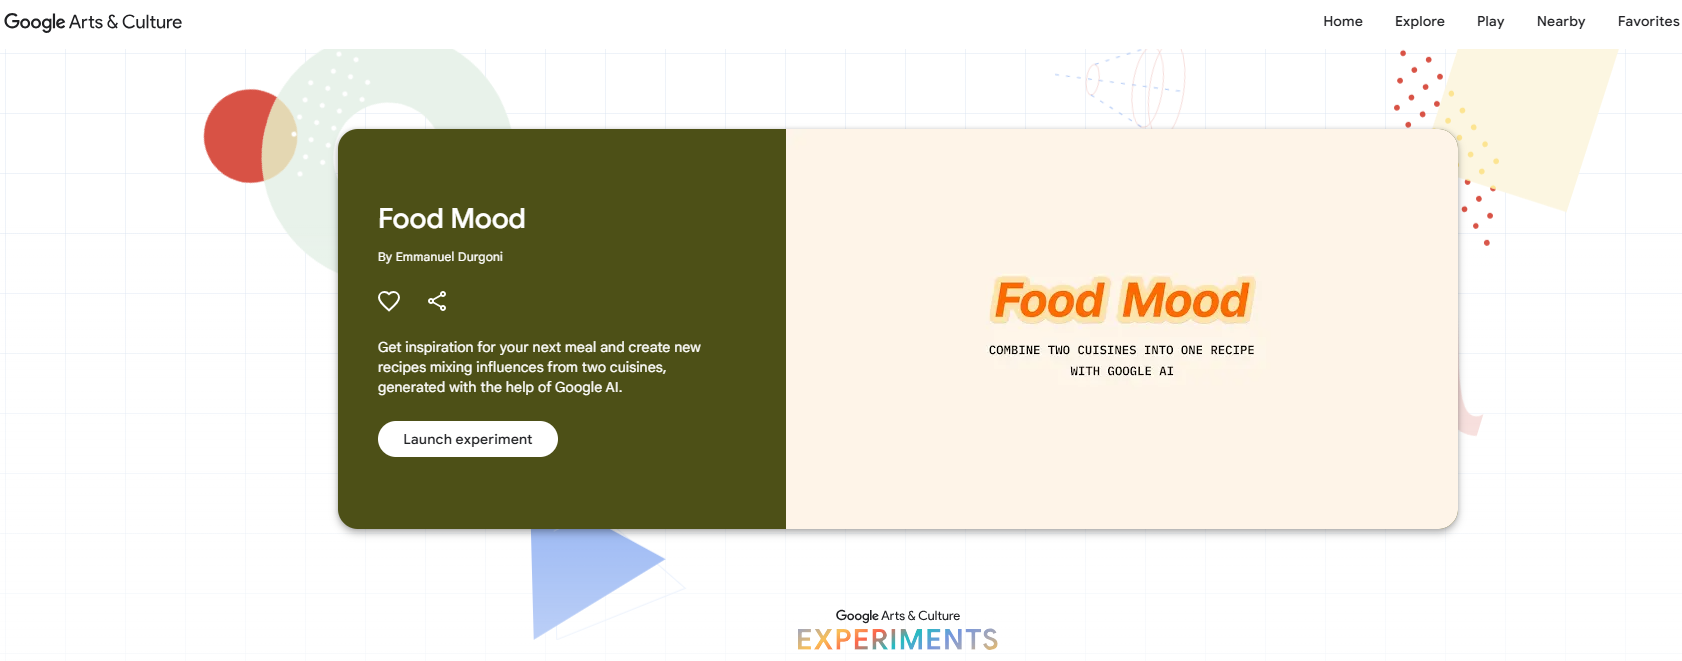
閱讀文章 →每次打開外送平台,滑了半天,卻還是想不到要吃什麼? 這種「選擇障礙」大家應該都有共鳴吧! 不過,Google Arts & Culture 最近推出了一款超療癒的小工具,名字就叫做 Food Mood,讓AI幫你將兩道菜餚融合成全新的食譜,輕鬆找到下一頓的靈感!
閱讀文章 →現在幾乎人人都在用 AI,不管是 ChatGPT、Claude 還是其他工具,但你有沒有遇過明明已經輸入一大串問題,AI 卻給了一個「嗯?這不是我要的答案」的回覆? 那很有可能不是 AI 不聰明,而是我們的 提示語(Prompt)寫得不夠清楚 。 今天就來跟你分享 5 個簡單又實用的提示語寫作技巧,讓你每次問 AI,都能得到更精準、更符合你想像的回答! 技巧
閱讀文章 →你知道嗎?現在不只是真人能扮演多重角色,AI 也能切換身分,變成你工作與生活中的萬用幫手。 很多人使用 ChatGPT 只是單純問問題,但如果你會一個關鍵技巧「角色扮演(Role Prompting)」,它就能瞬間變身為商業顧問、醫學專家、甚至頂尖行銷長,幫你分析策略、設計行銷計劃、解釋醫療報告……簡直就像請了一個多功能專家團隊!
閱讀文章 →你是否曾經在 ChatGPT 或其他 AI 工具前卡關,心中在想:「我不知道該怎麼問,才能得到我要的答案!」 恭喜你已經遇上了「提示工程(Prompt Engineering)」領域的起點。
閱讀文章 →為什麼我們需要植物來淨化空氣? 現在的空氣品質越來越差,空氣中充斥著許多肉眼看不見的污染物質,不僅影響環境,也會對人體呼吸道造成潛在傷害。尤其在需要維持高品質空氣的環境中(如醫療、辦公室、居家空間等),良好的空氣處理更是不可或缺。 今天想跟大家分享一項來自美國太空總署 NASA 的經典研究。他們在研究密閉的太空站環境中,探索一種 低能源消耗、又能有效淨化空氣的方式,於是開始測試植物的空氣淨化能力。
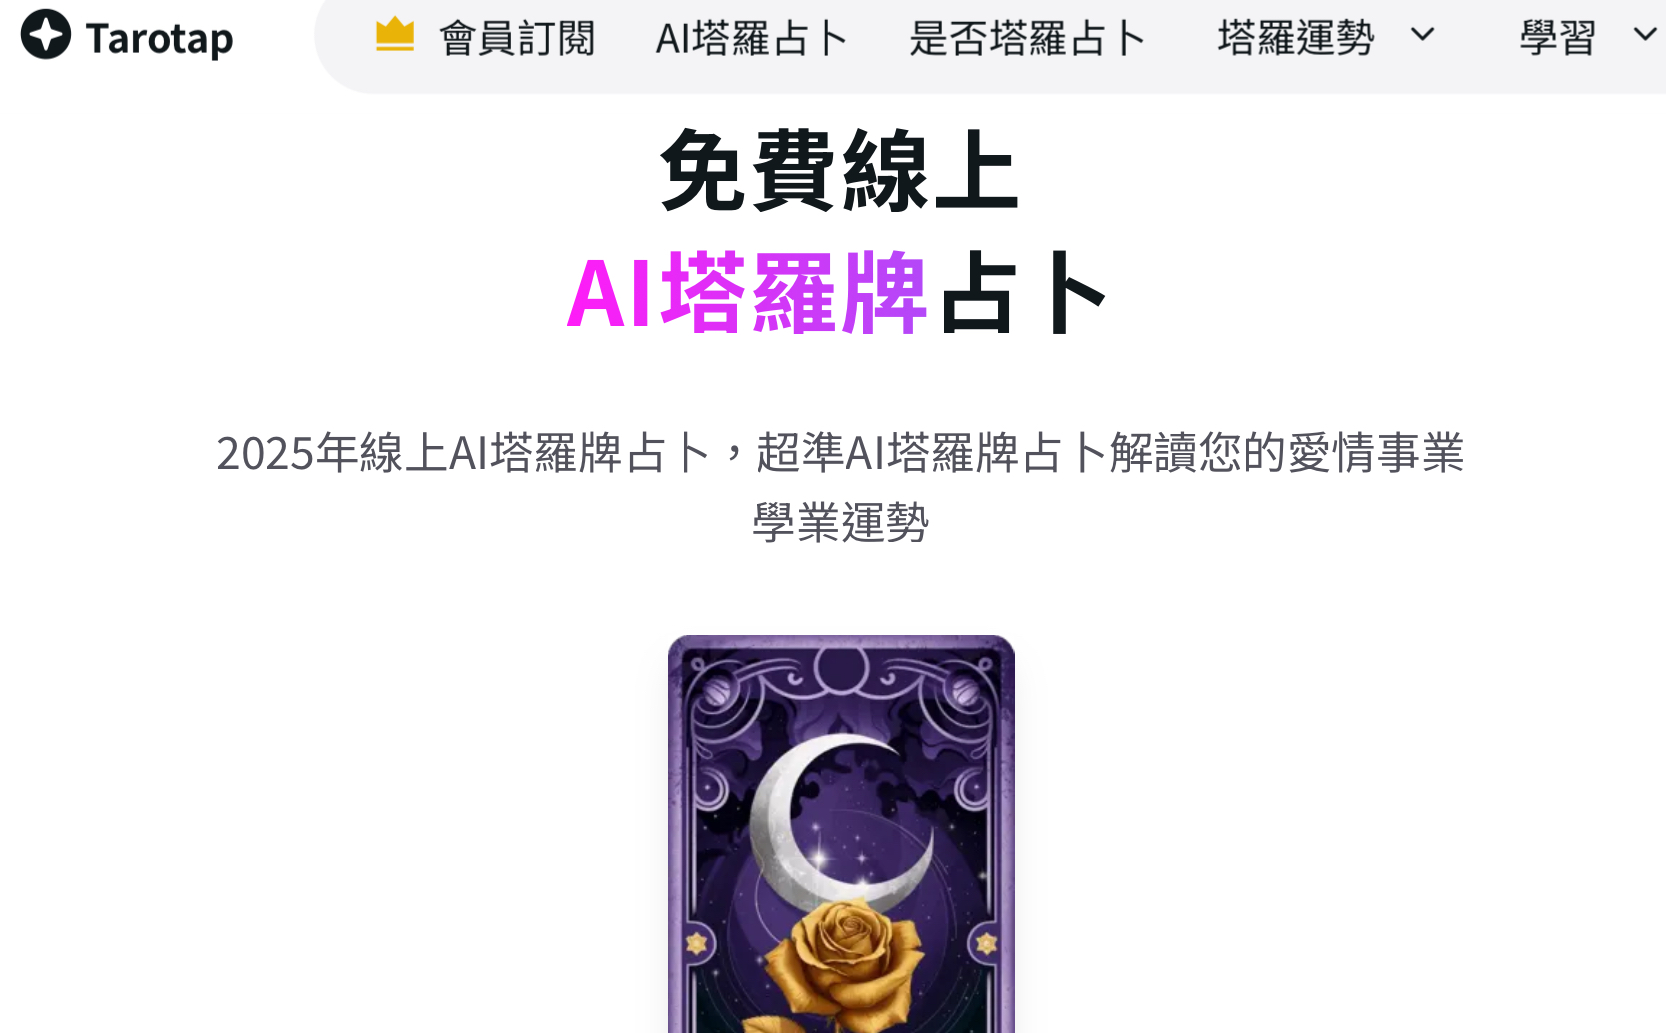
閱讀文章 →最近 AI 真的是無所不在,連塔羅占卜都能請 AI 幫忙了!如果你也是那種早上起來就想看看今天運勢怎麼樣、或者遇到選擇障礙時想問問宇宙的朋友,那你一定會喜歡這個我最近發現的神器 - Tarotap 塔羅耳語。
閱讀文章 →在資料分析領域當中,我們在最初會探索資料特徵之間的關聯性,而資料特徵的主要類別為連續型資料以及類別型資料,本篇文章當中所提到的皮爾森相關係數(Pearson Correlation Coefficient),是用來估計兩個連續型資料資料之間的線性關係,用以比較它們的關係程度。
閱讀文章 →快速學習如何從 PDF 中提取文字!本指南深度解析 pdfplumber、PyPDF2 及 pytesseract 三大工具,教你如何處理電子檔與掃描 PDF,解決中文亂碼問題,實現自動化報表分析,是程式小白必看的 PDFtoTXT 教學。
閱讀文章 →想打造私人 AI 知識庫?本文教你用 Docker 安裝 AnythingLLM。從環境安裝、Docker 指令到網頁端啟動,5 分鐘手把手教學,讓你輕鬆在本地端運行 100% 隱私安全的個人 AI 工作站。
閱讀文章 →想學寫程式卻卡在環境安裝?本教學專為程式初學者設計,手把手教你如何使用 Docker、Python 與 Visual Studio Code (VS Code) 打造標準化開發環境。從 Docker Desktop 安裝、Dockerfile 設定到 Dev Containers 部署,讓你快速進入開發實戰!
閱讀文章 →分群分布圖(Cluster Distribution Plot)是在商業分析當中,一種常見的視覺化分群分析工具,主要用於顯示資料集當中的不同群體(clusters)以及其分佈情況。 我們可以利用此圖表幫助我們理解資料分群當中隱含的結構資訊,用以辨識不同群體當中具有相似性和差異性的部分。
閱讀文章 →目標達成率圖是一種商業圖表的呈現方式,主要用來顯示實際表現與預設目標之間的關係。 通常用於比較實際數據(如銷售額、客戶留存率等)與預期目標,能夠幫助團隊快速識別哪些目標已經達成、尚未達成,或是達成程度的狀態。
閱讀文章 →在商業領域中,許多的業務推行和決策往往需要多加考慮在進行決策的調整,調整的目的不外乎是希望提升業務收入,或者降低成本,本篇內容將介紹收益成本分析圖(Profit-Cost Curve),讓機器學習模型在訓練的同時,就自動幫我們評估好模型最佳閾值(threshold),能夠讓業務推行的同時,在收益與成本的管控上取得更好的平衡。
閱讀文章 →很多時候我們在網路上看到有關軟體開發的教學文章,都會事先呈現撰寫程式的資料夾目錄,尤其是越大型的專案開發,越需要更加明確的專案目錄進行規劃,下面麥特會介紹使用計種不同方法將專案目錄呈現出來的方式,不管是在學校的專題報告、工作報告,甚至是軟體開發的教學文章,都可以讓人更加容易的理解其專案目錄的內容唷!
閱讀文章 →在機器學習領域當中,有效的理解模型的偏差(Bias)和變異數(Variance)是一種分析和理解模型泛化誤差(generalization error)技術的一中方式,經由判斷出誤差的類型,我們可以更有信心的調整資料特徵以及模型超參數的設定。
閱讀文章 →想提升工作效率?關鍵在於吃對堅果!本文解析核桃、松子、開心果等堅果中的 Omega-3 與 Omega-6 營養成分,教你掌握 1:4 的黃金比例,平衡現代飲食造成的發炎問題,是上班族不可或缺的高效飲食觀念科普。
閱讀文章 →Hoeffding 不等式(Hoeffding’s Inequality)是一個經典的概率不等式,用於分析二元隨機變量和的偏離程度。在機器學習中,它可以幫助估計模型的泛化誤差(Generalization Error),也就是模型在訓練集上的表現與在測試集上的表現的差異。
閱讀文章 →推導模型的泛化誤差方法 泛化誤差的估計方法包括下列幾種方式,可以直接點擊下面的連結,會開啟新分頁。 Rademacher Complexity (拉德馬赫複雜度) VC 維度(Vapnik-Chervonenkis 維度) Hoeffding 不等式(Hoeffding’s Inequality) PAC 學習框架中的界限(Probably Approxim
閱讀文章 →VC 維度(Vapnik-Chervonenkis 維度)是一種統計分類模型複雜性的指標。它由 Vladimir Vapnik 和 Alexey Chervonenkis 提出,主要用於學習理論(Learning Theory)和統計學中。
閱讀文章 →Rademacher Complexity(拉德馬赫複雜度) 是機器學習理論中的一個重要概念,用於衡量假設空間(模型集合)的複雜度,它是用來評估模型泛化能力(Generalization Ability)的一種工具。
閱讀文章 →PAC 學習(Probably Approximately Correct Learning)是機器學習理論中的一個重要框架,它提供了一種分析學習演算法的泛化能力(generalization ability)的方法。
閱讀文章 →麥特在攻讀研究所的時候,對於特徵工程領域有非常強烈的興趣,所以搜尋到Sequential Feature Selector序列特徵選擇法這項特徵選擇技術,而其中又有不同的改良方法,我在撰寫碩士論文的內容中,就有使用到序列特徵選擇法來進行特徵的挑選,也讓最後建立的模型有不錯的表現。
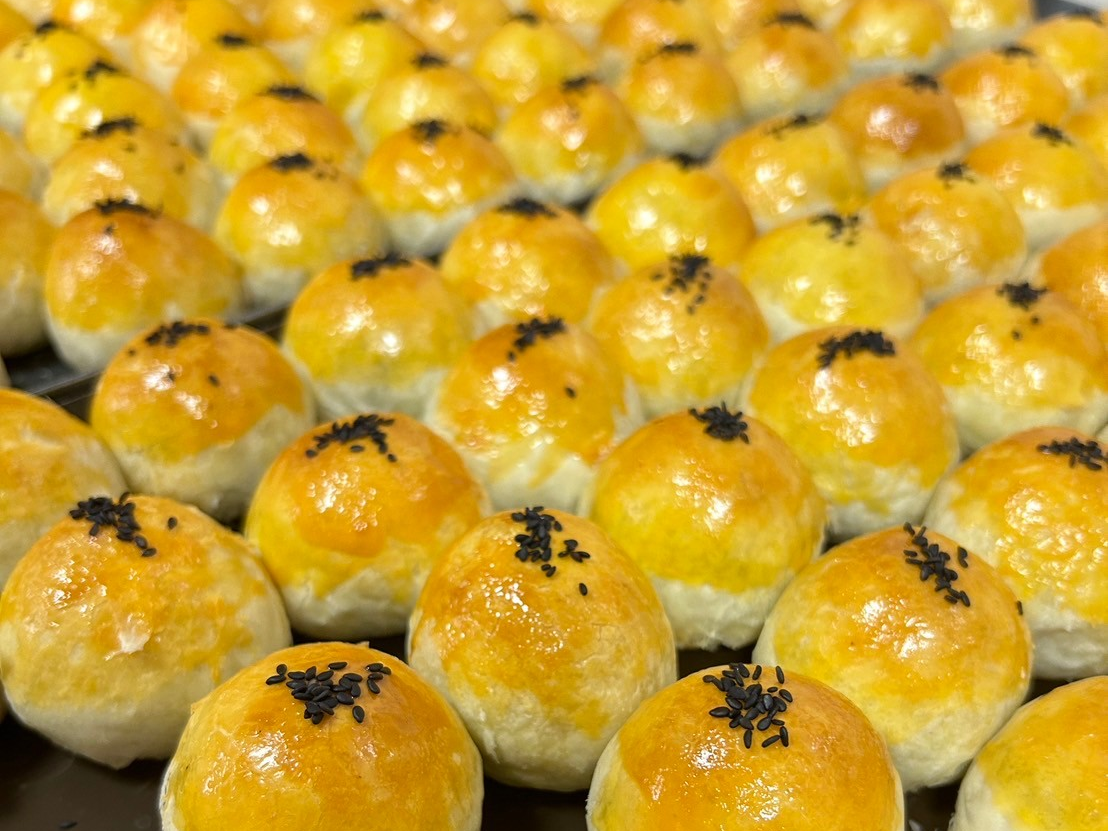
閱讀文章 →每年的中秋節,麥特會和另一半一起製作中秋節月餅,對於熱愛烘焙的人來說,應該都會對於烤出外皮酥脆的蛋黃酥以及在儲存過程中保持蛋黃酥的酥度,一直都是個不小的挑戰。
閱讀文章 →當業務部門向AI開發人員詢問,請問你的分類預測模型的效能表現很好,但是我希望可以藉由你的模型結果,向客戶說明AI模型提升的幅度,請問有更直觀的說明方式嗎?
閱讀文章 →TPOT (Tree-based Pipeline Optimization Tool) 是一個自動化機器學習(AutoML)的 Python 工具,主要是希望簡化機器學習模型的建模過程,TPOT利用遺傳編程來自動設計和優化機器學習管道,讓非專業的資料科學研究人員也能輕鬆使用機器學習技術。
閱讀文章 →想提升模型可靠度?本篇文章專為資料分析初學者設計,深入解析關鍵模型評估指標:機率校正曲線圖 (Probability Calibration curves)。透過 Python 與 Scikit-learn 實作,教你如何觀察模型預測信心,讓 AI 預測不再是黑盒子的瞎猜。
閱讀文章 →探索式資料分析(EDA)是在獲得第一手資料後,進行最初的資料觀察與洞見,鑑於不同資料對應該領域的背景知識,身為資料分析人員的我們只能在資料當中探索出相關的資訊,此時自動化探索式資料分析工具就能夠發揮其作用。
閱讀文章 →想學 Python 資料分析卻卡在環境安裝?本文推薦 5 款實用的程式工具,教你如何自動生成 requirements.txt,解決套件版本不相容問題。從 pip freeze 到 pipreqs,助你快速建立乾淨、標準的開發環境,新手也能輕鬆上手!
閱讀文章 →想提升模型準確率?本文教你如何使用 RFE (Recursive Feature Elimination) 遞迴特徵消除法。作為特徵工程中強大的包裝法 (Wrapper method) 技術,RFE 能自動篩選重要變數、優化特徵選擇並降低過擬合。適合程式初學者搭配 Python Scikit-learn 實作。
閱讀文章 →麥特在假日期間的興趣是製作烘焙產品,而最近推出的蛋糕產品質地柔軟,表面的淋醬也是需要進行冷藏保存的,一旦拿到室溫太久就會變軟,這時候將蛋糕切開來的難度就會大幅上升,除了切不漂亮以外,另一大問題就是更不能平均切分數量,所以麥特在本篇文章當中,會介紹幾個切出漂亮蛋糕切麵的技巧,在麵包、慕斯、塔類等等產品上面也都適用此技巧唷!
閱讀文章 →Surveyon除了經典的網路問卷調查以外,也有參與投票進行賺積分的方式,一起來看看如何進行Surveyon網路賺錢!最低1美金即可出金囉!
閱讀文章 →想提升機器學習準確度嗎?本文專為程式初學者設計,深度解析特徵工程 (Feature Engineering) 核心概念。從資料轉換到關鍵的特徵選擇,詳解 Filter Methods 與 Wrapper Methods 的優缺點,助你優化資料結構,打造最強預測模型。
閱讀文章 →Honeygain 是一款被動收入應用程序,可以從手機或電腦上沒有使用到的網路頻寬中賺錢。只要下載Honeygain的app保持在後台運作的狀態就可以開始賺錢囉 !
閱讀文章 →Rakuten Insight是日本樂天集團旗下專門搜集用戶意見,進行問卷調查的平台,填寫問卷即可累積點數,點數與台幣的比例大約是10:1,累積至2000點就可以申請出金200塊台幣到銀行帳戶,算是少數能夠直接回饋現金到戶頭的問卷調查任務。
閱讀文章 →近幾年在人工智慧爆發性的成長後,我們發現人工智慧(Artificial Intelligence, AI),往往在專精單一領域的技術上面,幾乎可以是完勝人類數十或數百年來的智慧結晶,而鑒於此,身為人類的我們,最終還能留下甚麼能夠與AI所抗衡的呢 ?
閱讀文章 →每個人都會有生活所需要的代步工具,在中華民國萬萬稅的台灣,每年需要面臨到的就是各式各樣的稅賦需要繳納,不曉得大家在汽車的投保上,是不是都有清楚的了解車險是不是符合自身的需求呢?就讓麥特來跟大家分享有哪些細節吧!
閱讀文章 →在獲取第一手資料的當下,可以讓人快速了解整體資料分佈的樣貌時,最好的方式就是將資料進行視覺化(Exploratory Data Analysis, EDA),而我們在尚未熟悉這份資料的時候,進行的視覺化分析,就被稱作探索式資料分析技巧。
閱讀文章 →想學資料分析卻不知道如何下手?本教學專為程式初學者設計,深入淺出講解「資料清洗」與「資料前處理」的核心概念。教你如何處理缺失值、錯誤值與離群值,並透過視覺化工具如盒鬚圖快速判斷數據品質,奠定扎實的分析基礎。
閱讀文章 →Premise 是一款在手機上使用的問卷調查應用程式,每個問卷的時間約在3-4分鐘左右,同時有機會可以接到拍攝相關任務,需要到實際地點進行拍攝上傳,而拍攝的任務回饋相當的不錯,是一款可以在無聊的時候打開APP,幫自己賺取收入的好方法。
閱讀文章 →在進行資料分析之前,最重要的就是釐清自己的研究流程,簡單的介紹資料分析與機器學習會使用到的研究流程,讓大家可以清楚知道自己的分析步驟,並說明兩種研究上的相同與相異處,在完成了第一次的流程之後,也能視自己的需求在不同的環節進行優化唷!
閱讀文章 →[ez-toc] 哈囉,我是麥特,目前從事數據分析相關的職務,想要在這個地方跟大家分享和資料有關的知識,以及網路賺錢的技能,期許自己能夠成為獨當一面的數位工作者。 在我的部落格中主要想和大家分享三大類型的主題,包含: 資料分析 Data Analysis 在資料分析的部分,會跟大家分享有關於分析的流程,以及我平常在工作上覺得不錯的工具,會盡量使用容易理解的方
閱讀文章 →