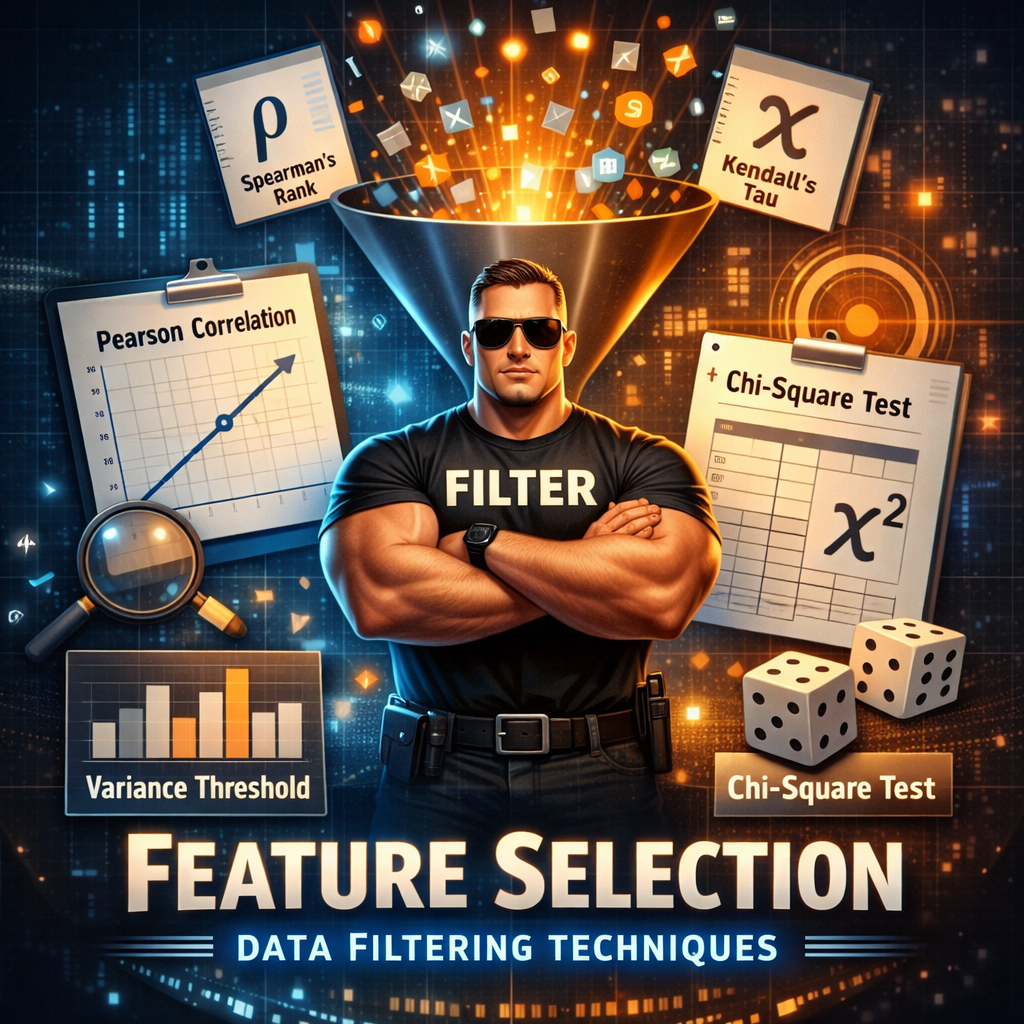
欄位太多模型算不動?五種「過濾法」幫你精準抓出數據裡的關鍵訊號
嘿,你曾經遇過這種狀況嗎? 當你拿到一份資料集,滿心期待地想跑個機器學習模型,結果打開檔案一看——欄位(Features)多到要橫向捲動好幾秒才看得完。這時候,如果你直接把這幾百個欄位全部丟進模型裡,通常會發生兩件事:第一,你的電腦風扇開始狂轉,模型跑得比烏龜還慢;第二,預測結果爛得一塌糊塗,因為裡面充斥著太多無關的「雜訊」。
閱讀文章 →共 28 篇文章
嘿,你曾經遇過這種狀況嗎? 當你拿到一份資料集,滿心期待地想跑個機器學習模型,結果打開檔案一看——欄位(Features)多到要橫向捲動好幾秒才看得完。這時候,如果你直接把這幾百個欄位全部丟進模型裡,通常會發生兩件事:第一,你的電腦風扇開始狂轉,模型跑得比烏龜還慢;第二,預測結果爛得一塌糊塗,因為裡面充斥著太多無關的「雜訊」。
閱讀文章 →假設你是一位資料分析師,負責監測工業設備的健康狀態。 設備每天都在固定的周期模式下運轉,你希望找出潛在的異常,並預測設備的退化情況。 在這個情境下,固定周期特徵測試 (Fixed Cycle Features Test, FCFT) 提供了一種精簡但功能強大的方法,幫助你提取穩定狀態的訊號並進行深入分析。
閱讀文章 →驗證性資料分析(Confirmatory Data Analysis, CDA)是一種以假設為導向的資料分析方法,主要用於驗證或拒絕事前提出的假設。
閱讀文章 →在資料分析的世界裡,我們經常聽到「探索性資料分析(EDA)」這個詞,但其實在真正進入嚴謹的統計推論之前,有一個更具系統性的步驟,那就是「驗證性資料分析」(Confirmatory Data Analysis, CDA)。這篇文章將帶你從概念出發,理解 CDA 的定位與用途,並說明它在資料科學與研究中的重要性。
閱讀文章 →在資料分析領域當中,我們在最初會探索資料特徵之間的關聯性,而資料特徵的主要類別為連續型資料以及類別型資料,本篇文章當中所提到的皮爾森相關係數(Pearson Correlation Coefficient),是用來估計兩個連續型資料資料之間的線性關係,用以比較它們的關係程度。
閱讀文章 →分群分布圖(Cluster Distribution Plot)是在商業分析當中,一種常見的視覺化分群分析工具,主要用於顯示資料集當中的不同群體(clusters)以及其分佈情況。 我們可以利用此圖表幫助我們理解資料分群當中隱含的結構資訊,用以辨識不同群體當中具有相似性和差異性的部分。
閱讀文章 →目標達成率圖是一種商業圖表的呈現方式,主要用來顯示實際表現與預設目標之間的關係。 通常用於比較實際數據(如銷售額、客戶留存率等)與預期目標,能夠幫助團隊快速識別哪些目標已經達成、尚未達成,或是達成程度的狀態。
閱讀文章 →在商業領域中,許多的業務推行和決策往往需要多加考慮在進行決策的調整,調整的目的不外乎是希望提升業務收入,或者降低成本,本篇內容將介紹收益成本分析圖(Profit-Cost Curve),讓機器學習模型在訓練的同時,就自動幫我們評估好模型最佳閾值(threshold),能夠讓業務推行的同時,在收益與成本的管控上取得更好的平衡。
閱讀文章 →很多時候我們在網路上看到有關軟體開發的教學文章,都會事先呈現撰寫程式的資料夾目錄,尤其是越大型的專案開發,越需要更加明確的專案目錄進行規劃,下面麥特會介紹使用計種不同方法將專案目錄呈現出來的方式,不管是在學校的專題報告、工作報告,甚至是軟體開發的教學文章,都可以讓人更加容易的理解其專案目錄的內容唷!
閱讀文章 →在機器學習領域當中,有效的理解模型的偏差(Bias)和變異數(Variance)是一種分析和理解模型泛化誤差(generalization error)技術的一中方式,經由判斷出誤差的類型,我們可以更有信心的調整資料特徵以及模型超參數的設定。
閱讀文章 →Hoeffding 不等式(Hoeffding’s Inequality)是一個經典的概率不等式,用於分析二元隨機變量和的偏離程度。在機器學習中,它可以幫助估計模型的泛化誤差(Generalization Error),也就是模型在訓練集上的表現與在測試集上的表現的差異。
閱讀文章 →推導模型的泛化誤差方法 泛化誤差的估計方法包括下列幾種方式,可以直接點擊下面的連結,會開啟新分頁。 Rademacher Complexity (拉德馬赫複雜度) VC 維度(Vapnik-Chervonenkis 維度) Hoeffding 不等式(Hoeffding’s Inequality) PAC 學習框架中的界限(Probably Approxim
閱讀文章 →VC 維度(Vapnik-Chervonenkis 維度)是一種統計分類模型複雜性的指標。它由 Vladimir Vapnik 和 Alexey Chervonenkis 提出,主要用於學習理論(Learning Theory)和統計學中。
閱讀文章 →Rademacher Complexity(拉德馬赫複雜度) 是機器學習理論中的一個重要概念,用於衡量假設空間(模型集合)的複雜度,它是用來評估模型泛化能力(Generalization Ability)的一種工具。
閱讀文章 →PAC 學習(Probably Approximately Correct Learning)是機器學習理論中的一個重要框架,它提供了一種分析學習演算法的泛化能力(generalization ability)的方法。
閱讀文章 →麥特在攻讀研究所的時候,對於特徵工程領域有非常強烈的興趣,所以搜尋到Sequential Feature Selector序列特徵選擇法這項特徵選擇技術,而其中又有不同的改良方法,我在撰寫碩士論文的內容中,就有使用到序列特徵選擇法來進行特徵的挑選,也讓最後建立的模型有不錯的表現。
閱讀文章 →當業務部門向AI開發人員詢問,請問你的分類預測模型的效能表現很好,但是我希望可以藉由你的模型結果,向客戶說明AI模型提升的幅度,請問有更直觀的說明方式嗎?
閱讀文章 →TPOT (Tree-based Pipeline Optimization Tool) 是一個自動化機器學習(AutoML)的 Python 工具,主要是希望簡化機器學習模型的建模過程,TPOT利用遺傳編程來自動設計和優化機器學習管道,讓非專業的資料科學研究人員也能輕鬆使用機器學習技術。
閱讀文章 →想提升模型可靠度?本篇文章專為資料分析初學者設計,深入解析關鍵模型評估指標:機率校正曲線圖 (Probability Calibration curves)。透過 Python 與 Scikit-learn 實作,教你如何觀察模型預測信心,讓 AI 預測不再是黑盒子的瞎猜。
閱讀文章 →探索式資料分析(EDA)是在獲得第一手資料後,進行最初的資料觀察與洞見,鑑於不同資料對應該領域的背景知識,身為資料分析人員的我們只能在資料當中探索出相關的資訊,此時自動化探索式資料分析工具就能夠發揮其作用。
閱讀文章 →想學 Python 資料分析卻卡在環境安裝?本文推薦 5 款實用的程式工具,教你如何自動生成 requirements.txt,解決套件版本不相容問題。從 pip freeze 到 pipreqs,助你快速建立乾淨、標準的開發環境,新手也能輕鬆上手!
閱讀文章 →想提升模型準確率?本文教你如何使用 RFE (Recursive Feature Elimination) 遞迴特徵消除法。作為特徵工程中強大的包裝法 (Wrapper method) 技術,RFE 能自動篩選重要變數、優化特徵選擇並降低過擬合。適合程式初學者搭配 Python Scikit-learn 實作。
閱讀文章 →想提升機器學習準確度嗎?本文專為程式初學者設計,深度解析特徵工程 (Feature Engineering) 核心概念。從資料轉換到關鍵的特徵選擇,詳解 Filter Methods 與 Wrapper Methods 的優缺點,助你優化資料結構,打造最強預測模型。
閱讀文章 →在獲取第一手資料的當下,可以讓人快速了解整體資料分佈的樣貌時,最好的方式就是將資料進行視覺化(Exploratory Data Analysis, EDA),而我們在尚未熟悉這份資料的時候,進行的視覺化分析,就被稱作探索式資料分析技巧。
閱讀文章 →想學資料分析卻不知道如何下手?本教學專為程式初學者設計,深入淺出講解「資料清洗」與「資料前處理」的核心概念。教你如何處理缺失值、錯誤值與離群值,並透過視覺化工具如盒鬚圖快速判斷數據品質,奠定扎實的分析基礎。
閱讀文章 →在進行資料分析之前,最重要的就是釐清自己的研究流程,簡單的介紹資料分析與機器學習會使用到的研究流程,讓大家可以清楚知道自己的分析步驟,並說明兩種研究上的相同與相異處,在完成了第一次的流程之後,也能視自己的需求在不同的環節進行優化唷!
閱讀文章 →